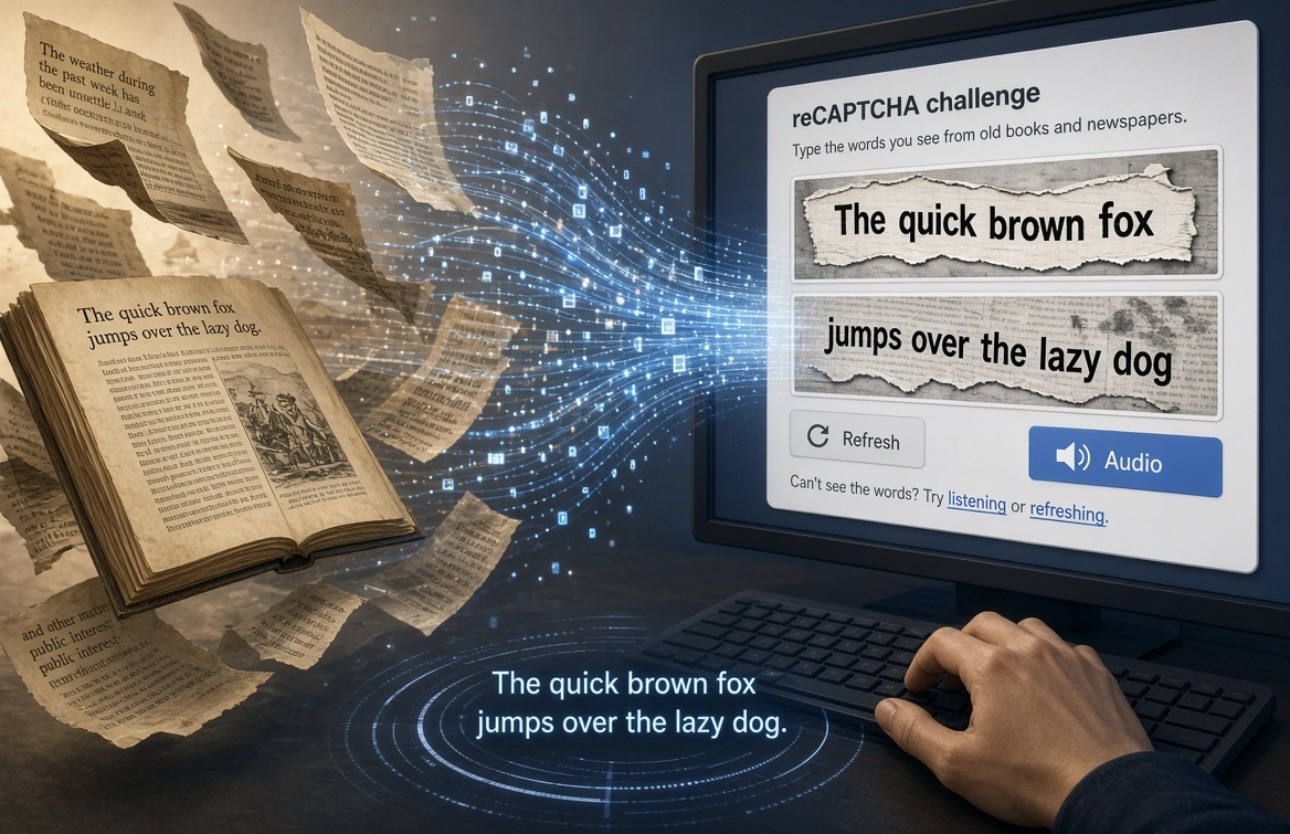

Σχεδόν όλοι έχουμε πληκτρολογήσει στρεβλά γράμματα για να αποδείξουμε ότι δεν είμαστε ρομπότ. Λίγοι γνωρίζουν ότι, για ένα διάστημα, αυτή η μικρή καθημερινή αγγαρεία είχε και δεύτερο σκοπό: τη μετατροπή σαρωμένων σελίδων βιβλίων και εφημερίδων σε ψηφιακό κείμενο.
Από το CAPTCHA στο reCAPTCHA
Το CAPTCHA είναι ένα τεστ που προορίζεται να ξεχωρίζει ανθρώπους από προγράμματα. Στο Πανεπιστήμιο Carnegie Mellon, ο ερευνητής Λούις φον Αν (Luis von Ahn) και οι συνεργάτες του πρότειναν μια παραλλαγή: αντί να δείχνει τυχαία παραμορφωμένες λέξεις, το σύστημα θα χρησιμοποιούσε λέξεις από τυπωμένα κείμενα που τα προγράμματα οπτικής αναγνώρισης χαρακτήρων (OCR) δεν μπορούσαν να διαβάσουν. Έτσι κάθε απάντηση βοηθούσε στη διόρθωση της ψηφιοποίησης. Το σύστημα ονομάστηκε reCAPTCHA, και η εταιρεία ReCAPTCHA Inc. ιδρύθηκε το 2008.
Ο ρόλος της εφημερίδας New York Times
Σύμφωνα με μία από τις καταγραφές που εξετάσαμε, το πρώτο μεγάλο έργο ήταν η ψηφιοποίηση του αρχείου των New York Times, που ξεκινά από το 1851 και περιλαμβάνει περισσότερα από 13 εκατομμύρια άρθρα. Η πληροφορία δεν περιλαμβάνεται στις ανακοινώσεις της εξαγοράς. Βέβαιο είναι ότι η τεχνολογία χρησιμοποιήθηκε στη συνέχεια και για το Google Books.
Η εξαγορά
Η Google ανακοίνωσε την εξαγορά του reCAPTCHA στις 16 Σεπτεμβρίου 2009. Οι όροι δεν δημοσιοποιήθηκαν. Ο φον Αν παρέμεινε στη σχολή του Carnegie Mellon, ενώ εργαζόταν και στο γραφείο της Google στο Πίτσμπουργκ. Η εταιρεία δήλωσε ότι θα αξιοποιούσε την τεχνολογία τόσο για την ασφάλεια και την καταπολέμηση του spam όσο και για τη σάρωση βιβλίων και εφημερίδων.
Τι σημαίνει αυτό για μας
Το reCAPTCHA είναι χαρακτηριστικό παράδειγμα «πληθοπορισμού»: πολλοί άνθρωποι εκτελούν μικρές εργασίες που μαζί δίνουν ένα μεγάλο αποτέλεσμα. Ταυτόχρονα εγείρει ένα ερώτημα που συζητείται έκτοτε: κάθε χρήστης προσέφερε χωρίς αμοιβή εργασία, και μάλιστα χωρίς να το γνωρίζει στην αρχή. Από την άλλη πλευρά, το αποτέλεσμα ήταν ψηφιακά κείμενα που μπορούν να αναζητηθούν.
Η ιστορία δείχνει και κάτι ευρύτερο για τα προγράμματα αναγνώρισης κειμένου: έκαναν λάθη ακριβώς εκεί όπου ένας άνθρωπος διαβάζει εύκολα, και αυτό το κενό αξιοποίησε η ιδέα.
Τι ξέρουμε και τι όχι
Επιβεβαιωμένα: η προέλευση από το Carnegie Mellon, η εξαγορά τον Σεπτέμβριο του 2009 και η χρήση για ψηφιοποίηση κειμένων. Ανεπιβεβαίωτος από δεύτερη καταγραφή παραμένει ο ακριβής ρόλος στο αρχείο των New York Times, και άγνωστο το τίμημα της εξαγοράς.
